POK-ISI Lab 8
Files
Cvičenie 8 - Stabilita a interpretovateľnosť modelov
Navigation
- Príprava – úvodný kód
- Krok 1 · Úloha 1.1 – Stabilita koeficientov logistickej regresie
- Krok 2 · Úloha 2.1 – Globálne vysvetlenie (SHAP)
- Úloha 2.2 – Vysvetlenie predikcie jedného klienta
- Úloha 2.3 – Stabilita globálnej dôležitosti príznakov
- Krok 3 · Úloha 3.1 – Kontrafaktuálne vysvetlenie
- Úloha 3.2 – Monotónne obmedzenia
- Doplňujúce úlohy
- Zhrnutie – čo si zapamätať
Kompletné riešenie: doplnené TODO, skutočné výstupy z behu, grafy a vysvetlenie, čo z nich vyčítať. Dátová sada Give Me Some Credit (150 000 klientov, 6,7 % pozitívnych), rovnaké rozdelenie 60/20/20 ako v Cvičení 7.
Poznámka k dátam: OpenML bolo z môjho prostredia nedostupné, preto som načítal identickú Kaggle sadu (cs-training.csv) a premenoval stĺpce podľa zadania. Stĺpce môžu mať iné poradie ako v OpenML verzii, takže u teba sa môžu čísla líšiť v tretej desatinnej – závery sú rovnaké.
Príprava – úvodný kód
Training set: (90000, 10), calibration set: (30000, 10), test set: (30000, 10)
Share of the positive class: 0.067

Missing values in the training set:
monthly_income    17814
dependents         2316

Logistic regression  AUC on the test set 0.6968
Boosting             AUC on the test set 0.8624
Boosting (AUC 0,862) je výrazne lepší než logistická regresia (0,697). Logistickej regresii škodia dve veci, ktoré uvidíme aj ďalej: revolving_utilization má extrémne odľahlé hodnoty (medián 0,15, maximum ~50 000), takže po štandardizácii sú bežné hodnoty 0–1 prakticky nula, a stĺpce s omeškaniami obsahujú špeciálne kódy 96/98 namiesto skutočných počtov. Stromy sú voči obom problémom odolné, lineárny model nie.
Krok 1 · Úloha 1.1 – Stabilita koeficientov logistickej regresie
Doplnené TODO
for n_samples in [2000, len(X_train)]:
    coefs = []
    for seed in range(N_BOOTSTRAP):
        X_boot, y_boot = resample(X_train, y_train, n_samples=n_samples, stratify=y_train, random_state=seed)
        # TODO 1 – klon CELEJ pipeline (imputer + scaler + LR), aby sa aj medián a škálovanie
        #          naučili len z danej bootstrapovej vzorky
        boot_model = clone(linear_model).fit(X_boot, y_boot)
        coefs.append(boot_model[-1].coef_[0])          # posledný krok = LogisticRegression
    coef_samples[n_samples] = pd.DataFrame(coefs, columns=X.columns)

columns = {"coefficient": full_coef}
for n_samples, coefs in coef_samples.items():
    # TODO 2 – SD cez 100 opakovaní a podiel opakovaní s opačným znamienkom než referenčný model
    columns[f"SD (n = {n_samples})"] = coefs.std(ddof=1)
    columns[f"sign flips (n = {n_samples})"] = (np.sign(coefs) != np.sign(full_coef)).mean()
Prečo clone celej pipeline: keby sme preučili iba LR, imputer a scaler by ostali naučené na celej trénovacej množine → do bootstrapu by „presakovala“ informácia mimo vzorky a variabilita by bola podhodnotená.
Výstup
                       coefficient  SD (n = 2000)  sign flips (n = 2000)  SD (n = 90000)  sign flips (n = 90000)
revolving_utilization       -0.005          0.187                   0.23           0.014                    0.31
age                         -0.386          0.116                   0.00           0.016                    0.00
late_30_59                   2.049          0.444                   0.00           0.111                    0.00
debt_ratio                  -0.123          0.209                   0.27           0.042                    0.00
monthly_income              -0.377          0.261                   0.06           0.091                    0.00
open_credit_lines           -0.045          0.127                   0.37           0.018                    0.01
late_90                      1.961          0.725                   0.06           0.155                    0.00
real_estate_loans            0.085          0.120                   0.28           0.019                    0.00
late_60_89                  -3.856          1.651                   0.19           0.225                    0.00
dependents                   0.101          0.095                   0.12           0.014                    0.00

Pearson correlation of the three delinquency features:
            late_30_59  late_60_89  late_90
late_30_59       1.000       0.987    0.984
late_60_89       0.987       1.000    0.993
late_90          0.984       0.993    1.000
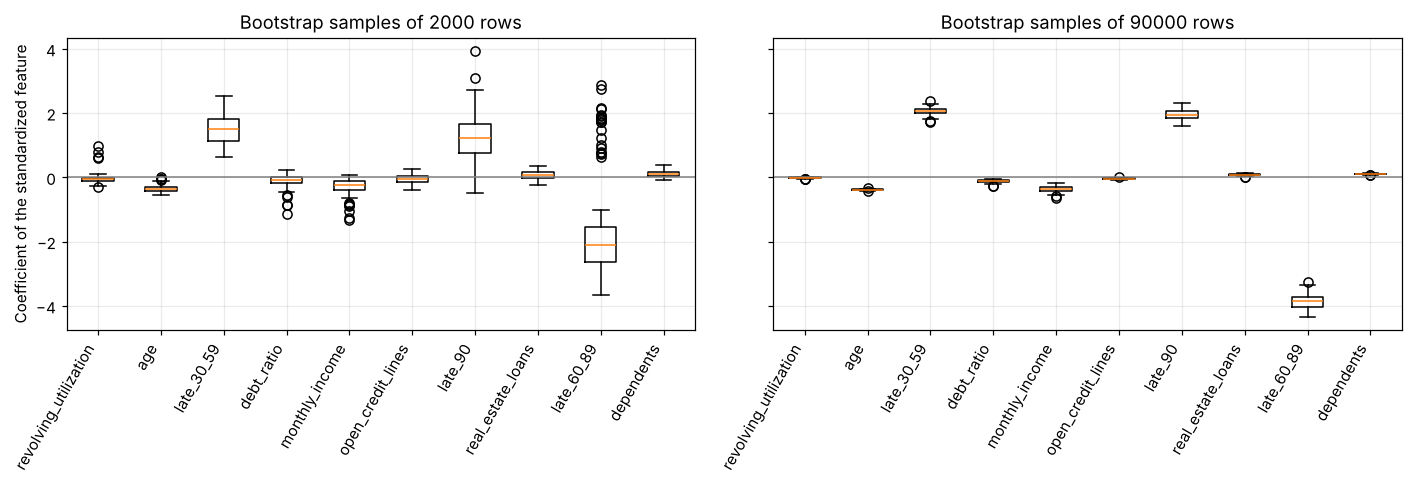
Rozdelenie koeficientov cez 100 bootstrapov (vľavo n = 2 000, vpravo n = 90 000).
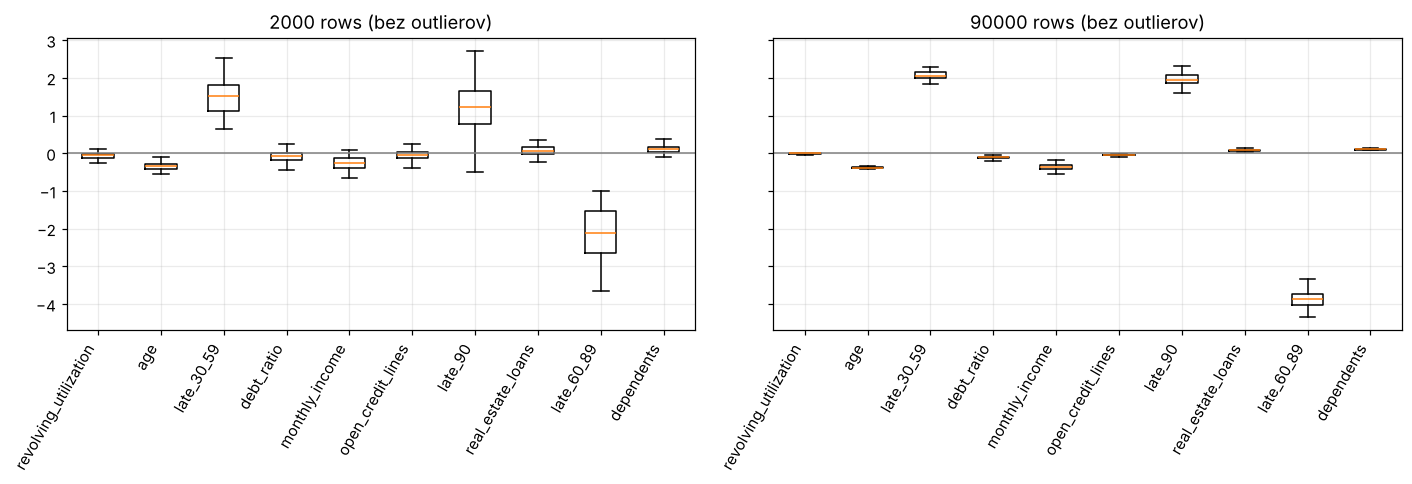
To isté bez odľahlých bodov – lepšie vidno rozptyl menších koeficientov.
Čo z toho plynie
- Veľkosť vzorky: pri 2 000 riadkoch sú SD veľké a päť príznakov mení znamienko v 19–37 % opakovaní (
open_credit_lines,real_estate_loans,debt_ratio,revolving_utilization,late_60_89). Pri 90 000 klesnú SD zhruba 5–8× (≈ √45 ≈ 6,7, ako predpovedá štatistika) a znamienka sa ustália. - Výnimka –
revolving_utilization: aj pri 90 000 riadkoch mení znamienko v 31 % prípadov. Koeficient je −0,005, teda prakticky nula a jeho znamienko je náhoda. Príčinou sú spomínané outliery – lineárny model tento príznak nevie využiť. Paradoxne je to pre boosting najdôležitejší príznak (Úloha 2.1). Nestabilné znamienko teda neznamená „nedôležitý príznak“, ale „model ho nevie použiť v tejto forme“. - Multikolinearita omeškaní: korelácie 0,98–0,99 medzi tromi stĺpcami omeškaní sú spôsobené 269 klientmi, ktorí majú vo všetkých troch stĺpcoch kód 96/98 (bez nich je korelácia len 0,22–0,31). Dôsledok:
late_60_89má koeficient −3,86 (akoby viac omeškaní znižovalo riziko!), kýmlate_30_59alate_90majú ~+2. Model si ich váhy „vymieňa“ – súčet dáva zmysel, jednotlivé znamienka nie. Tieto tri koeficienty majú aj najväčšie SD. Interpretovať koeficientlate_60_89samostatne by bola chyba. - Stabilné a zmysluplné sú napr.
age(−, starší = nižšie riziko) amonthly_income(−). Ani stabilita ale nie je dôkaz kauzality (pozri poznámku v zadaní).
Krok 2 · Úloha 2.1 – Globálne vysvetlenie (SHAP)
SHAP values: (2000, 10), base value: -3.562

Mean absolute SHAP value:
revolving_utilization    0.702
late_30_59               0.303
age                      0.226
late_90                  0.212
monthly_income           0.170
open_credit_lines        0.146
debt_ratio               0.125
late_60_89               0.122
real_estate_loans        0.095
dependents               0.024
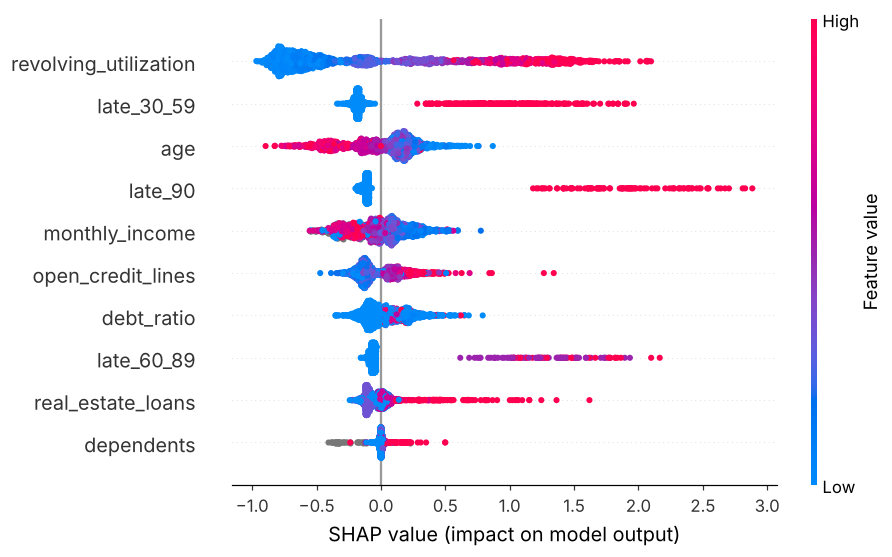
Rojový graf: poloha = príspevok k log-odds, farba = hodnota príznaku.
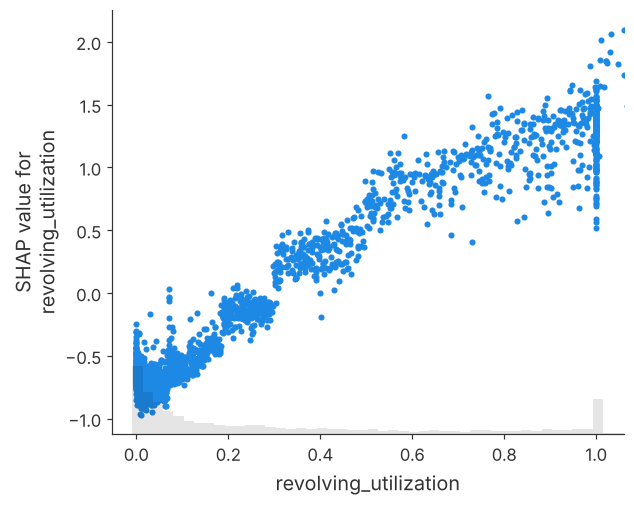
Graf závislosti pre najdôležitejší príznak revolving_utilization (os x do 99. percentilu).
- Základná hodnota −3,562 je priemerný výstup modelu v log-odds; sigmoid(−3,562) ≈ 0,028. Nie je to 0,067 (podiel triedy), lebo priemer log-odds ≠ log-odds priemernej pravdepodobnosti – väčšina klientov má veľmi nízke riziko a pár veľmi vysoké.
revolving_utilizationdominuje (0,70, viac než dvojnásobok druhého). Z rojového grafu: nízke čerpanie (modré) tlačí riziko dole až o ~1 log-odds, vysoké (červené) hore až o ~2.- Omeškania (
late_30_59,late_90,late_60_89) majú typický „asymetrický“ tvar: nula = malý záporný príspevok (zhluk tesne vľavo od 0), akékoľvek omeškanie = veľký kladný príspevok (dlhý chvost vpravo, prilate_90až +2,9). Preto je ich priemerná |SHAP| menšia, než by naznačovali extrémne prípady – väčšina klientov omeškania nemá. age: vysoký vek (červené) vľavo → starší klienti majú nižšie riziko;monthly_incomepodobne. Sivé body primonthly_income/dependentssú chýbajúce hodnoty – boosting si pre ne naučil vlastnú vetvu.- Graf závislosti je takmer monotónne rastúci, od ~−0,7 pri 0 po ~+1,5 pri 1. Zvislý rozptyl pri rovnakej hodnote x (najmä pri 1,0) ukazuje interakcie – rovnaké čerpanie znamená iný príspevok podľa ostatných príznakov. Zubatý, schodovitý tvar je typický pre stromy (prahy splitov).
Úloha 2.2 – Vysvetlenie predikcie jedného klienta
Raw model output:                   1.3619
Base value + sum of SHAP values:    1.3619
Probability from the SHAP values:   0.7961
Probability from predict_proba:     0.7961

                       feature_value  shap_value
late_90                        4.000       1.969
late_60_89                     3.000       1.065
revolving_utilization          0.950       0.845
late_30_59                     6.000       0.706
debt_ratio                     0.733       0.275
monthly_income              3878.000       0.082
age                           60.000      -0.030
dependents                     0.000      -0.024
open_credit_lines             12.000       0.021
real_estate_loans              0.000       0.016
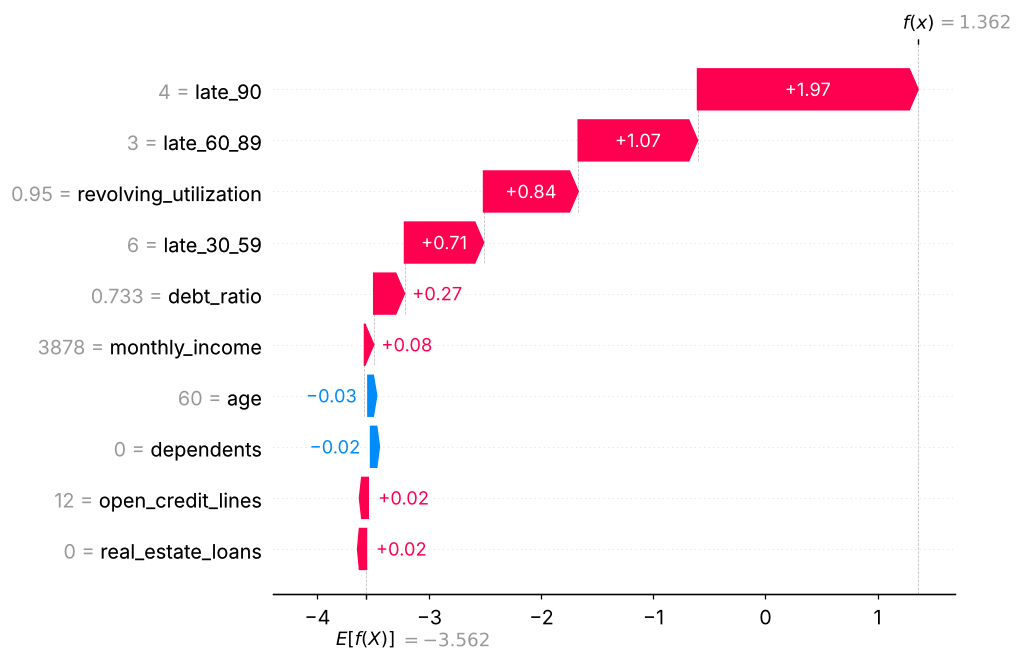
Vodopádový graf: od základnej hodnoty E[f(x)] = −3,56 k výstupu f(x) = 1,36 pre tohto klienta.
- Aditivita overená: −3,562 + Σ SHAP = 1,3619 =
decision_functionpresne; sigmoid(1,3619) = 0,7961 =predict_proba. To je základná vlastnosť (efficiency/local accuracy) Shapleyho hodnôt a TreeExplainer ju spĺňa presne. - Klient s 80 % rizikom: celkový posun je +4,92 log-odds. Takmer všetko tvorí história omeškaní (4× 90+ dní: +1,97; 3× 60–89: +1,07; 6× 30–59: +0,71 → spolu ~3,7) a vysoké čerpanie karty 0,95 (+0,85). Vek, príjem a ostatné sú zanedbateľné.
- Pozor na jednotky: príspevky sú v log-odds, nie v percentách. +1,97 neznamená +197 %, ale vynásobenie šance faktorom e1,97 ≈ 7,2.
Úloha 2.3 – Stabilita globálnej dôležitosti príznakov
Members trained on 2000 rows, mean rank correlation between two members: 0.812
                       mean_importance     SD  best_rank  worst_rank
revolving_utilization            0.964  0.234          1           2
monthly_income                   0.587  0.111          1           4
debt_ratio                       0.535  0.111          2           5
age                              0.518  0.147          2           6
late_30_59                       0.398  0.102          2           9
open_credit_lines                0.350  0.060          5           8
late_90                          0.332  0.095          5          10
dependents                       0.201  0.074          6          10
late_60_89                       0.167  0.083          7          10
real_estate_loans                0.164  0.059          7          10

Members trained on 90000 rows, mean rank correlation between two members: 0.960
                       mean_importance     SD  best_rank  worst_rank
revolving_utilization            0.720  0.022          1           1
late_30_59                       0.297  0.015          2           2
age                              0.243  0.022          3           4
late_90                          0.211  0.006          4           5
monthly_income                   0.194  0.044          3           7
debt_ratio                       0.164  0.012          5           6
open_credit_lines                0.127  0.017          6           9
late_60_89                       0.121  0.004          7           9
real_estate_loans                0.102  0.015          7           9
dependents                       0.035  0.005         10          10
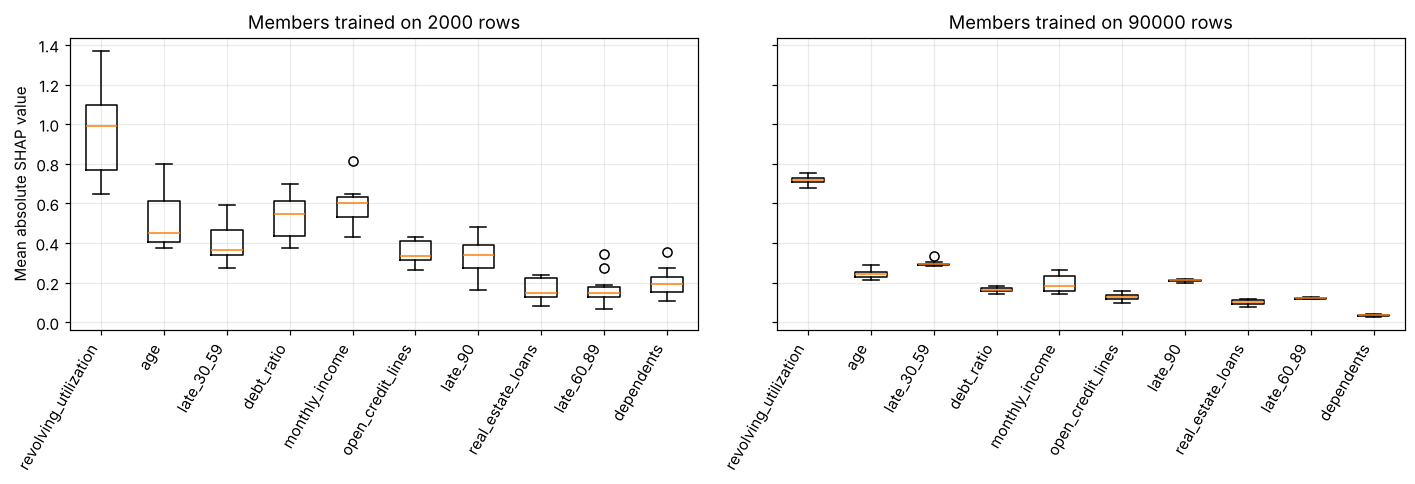
Priemerná |SHAP| cez 10 modelov natrénovaných na rôznych bootstrapových vzorkách.
- Malé vzorky (2 000): priemerná Spearmanova korelácia poradí 0,81 – poradie sa výrazne mení.
late_30_59skáče medzi 2. a 9. miestom,late_90medzi 5. a 10. Stabilne na vrchu je ibarevolving_utilization(1.–2.). - Pri malých dátach sa navyše mení aj charakter vysvetlenia: dôležitosti sú celkovo vyššie (preučené modely dávajú extrémnejšie log-odds) a do popredia sa dostávajú spojité príznaky s mnohými hodnotami (
monthly_income,debt_ratio,age) – stromy na nich ľahko nachádzajú splity, ktoré zachytia šum. Omeškania sú zriedkavé, v 2 000 riadkoch je pozitívnych klientov s omeškaním málo. - Veľké vzorky (90 000): korelácia 0,96, prvé dve miesta pevné, SD ~10× menšie. Najviac kolíše
monthly_income(3.–7., najväčšia SD) – má 20 % chýbajúcich hodnôt a súvisí sdebt_ratio(pomer dlhu k príjmu), takže si s ním model „delí“ informáciu podobne ako LR pri omeškaniach. - Záver: vysvetlenie modelu natrénovaného na malých dátach je rovnako nespoľahlivé ako model samotný. Pred interpretáciou má zmysel overiť stabilitu podobným bootstrapom.
Krok 3 · Úloha 3.1 – Kontrafaktuálne vysvetlenie
Doplnené TODO
def counterfactual(model, client_row, threshold=THRESHOLD, steps=21):
    factors = np.linspace(1, 0, steps)
    grid = pd.DataFrame([(a, b) for a in factors for b in factors],
                        columns=["factor_utilization", "factor_debt"])
    # TODO 1 – 441 kópií klienta, v každej prenásobené dva ovplyvniteľné príznaky
    candidates = pd.DataFrame([client_row] * len(grid)).reset_index(drop=True)
    candidates["revolving_utilization"] = client_row["revolving_utilization"] * grid["factor_utilization"]
    candidates["debt_ratio"] = client_row["debt_ratio"] * grid["factor_debt"]
    # TODO 2 – pravdepodobnosť pozitívnej triedy (finančné ťažkosti) pre každého kandidáta
    grid["proba"] = model.predict_proba(candidates)[:, 1]
    grid["change"] = (1 - grid["factor_utilization"]) + (1 - grid["factor_debt"])
    feasible = grid[grid["proba"] < threshold]
    if feasible.empty:
        return None, grid
    return feasible.sort_values(["change", "proba"]).iloc[0], grid
Výstup
Client near the threshold: probability 0.112, revolving_utilization 0.604, debt_ratio 0.963
  revolving_utilization 0.484, debt_ratio 0.963 -> probability 0.073
Client from Task 2.2: probability 0.796, revolving_utilization 0.950, debt_ratio 0.733
  no change of the actionable features is enough, lowest reachable probability 0.448

Rejected clients: 346, a counterfactual exists for 59.2% of them
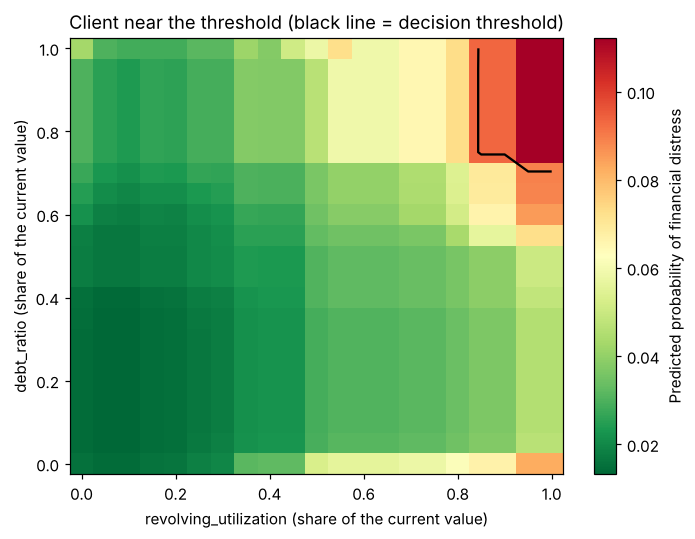
Predikovaná pravdepodobnosť pre všetkých 21×21 kombinácií zníženia (1 = bez zmeny, 0 = splatené). Čierna čiara = prah 0,091.
- Klient tesne nad prahom (p = 0,112): stačí znížiť čerpanie karty z 0,604 na 0,484 (na 80 %),
debt_rationetreba meniť → p = 0,073 < 0,091. Úver by dostal. - Klient z 2.2 (p = 0,796): žiadna kombinácia nestačí, ani úplné splatenie oboch (minimum 0,448). Jeho riziko tvorí história omeškaní, ktorú zmeniť nemôže – kontrafaktuál v ovplyvniteľných príznakoch neexistuje.
- Zo 2 000 klientov je zamietnutých 346 (17,3 %) a kontrafaktuál existuje pre 59,2 % z nich (v hrubšej mriežke 11×11). Zvyšok nemá „čo urobiť“.
- Prečo to nie je spoľahlivá rada (na diskusiu):
- Model je korelačný, nie kauzálny – zníženie čerpania v dátach súvisí s nižším rizikom, ale nevieme, či ho spôsobuje. Klient, ktorý si na splatenie karty požičia inde, riziko reálne neznížil.
- Zmena jedného príznaku v realite mení aj iné (splatenie dlhu zníži úspory, môže zmeniť
open_credit_lines), ale my ostatné držíme konštantné. - Povrch nie je monotónny a je „kockatý“: všimni si spodný riadok (
debt_ratio= 0) – riziko tam opäť stúpne do žlto-oranžovej. Nulovýdebt_ratioje v dátach neobvyklý (často pri chýbajúcom príjme), model ho trestá. Rada „splaťte všetky dlhy“ by teda podľa modelu bola horšia ako „splaťte trochu“ – čo je nezmysel. - Kontrafaktuál závisí od konkrétneho modelu – pri preučení (Úloha 2.3) sa môže zmeniť. Rovnako sa mení s voľbou metriky „najmenšej zmeny“ a mriežky.
Úloha 3.2 – Monotónne obmedzenia
Without constraints    AUC 0.8624, Brier 0.0494
Monotonic constraints  AUC 0.8639, Brier 0.0492

Share of clients whose predicted risk falls with more late payments:
model       Monotonic constraints  Without constraints
feature
late_30_59                    0.0                0.658
late_60_89                    0.0                0.044
late_90                       0.0                0.108
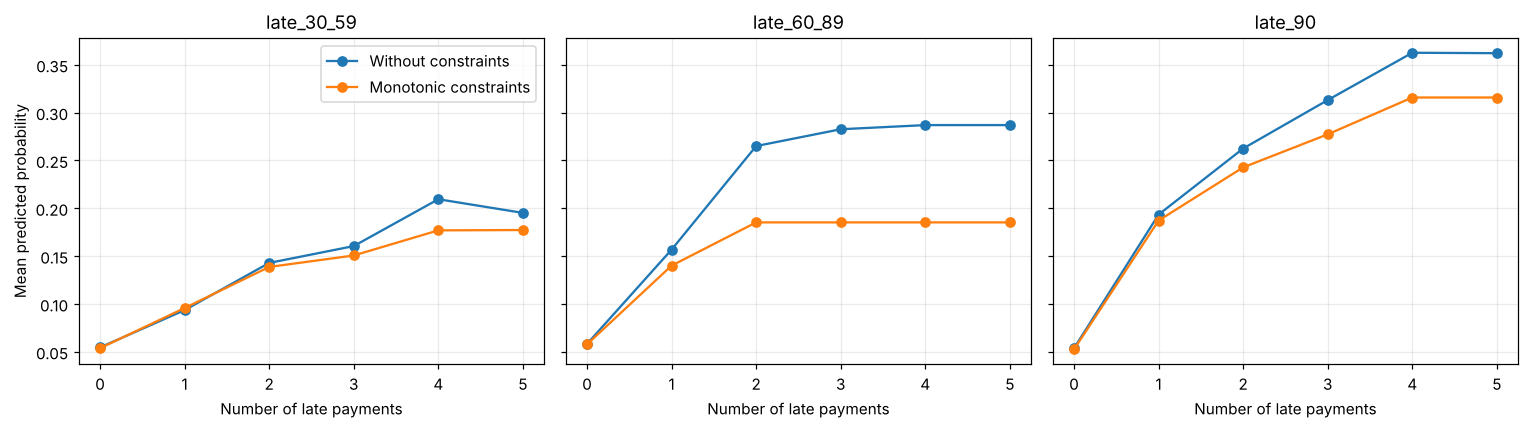
Priemerná predikovaná pravdepodobnosť pri nastavení počtu omeškaní na 0–5 (ostatné príznaky ponechané).
- Bez obmedzení model u 65,8 % klientov niekde zníži riziko, keď pridáme omeškanie 30–59 dní (aj priemerná krivka klesá zo 4 na 5). Pri
late_90je to 10,8 %, prilate_60_894,4 %. Pre banku neobhájiteľné: „mali ste o jedno omeškanie viac, tak dostanete úver“. Príčina: v oblasti 4–5 omeškaní je málo dát a model tam fituje šum (plus kódy 96/98). - S
monotonic_cstje podiel presne 0 pre všetky tri príznaky – je to garancia konštrukcie stromov, nie len empirický výsledok. - A cena? Žiadna – AUC dokonca mierne stúpol (0,8624 → 0,8639) a Brier mierne klesol (0,0494 → 0,0492). Obmedzenie funguje ako regularizácia založená na doménovej znalosti. Krivky s obmedzením sú nižšie a pri
late_60_89sa od 2 omeškaní „zastavia“ – model namiesto rastúceho šumu vyberie bezpečné plató.
Doplňujúce úlohy
1 · LIME pre klienta z Úlohy 2.2
from lime.lime_tabular import LimeTabularExplainer
imp = SimpleImputer(strategy="median").fit(X_train)
Xtr_imp = imp.transform(X_train)
row_imp = imp.transform(X_explain.iloc[[client]])[0]
predict_fn = lambda a: explained_model.predict_proba(pd.DataFrame(a, columns=X.columns))

for rs in [0, 1, 2]:
    lime_exp = LimeTabularExplainer(Xtr_imp, feature_names=list(X.columns),
                                    class_names=["ok", "distress"], mode="classification", random_state=rs)
    e = lime_exp.explain_instance(row_imp, predict_fn, num_features=5, labels=(1,))
    print(f"random_state={rs}:", e.as_list(label=1))
random_state=0:
  late_90 > 0.00                           +0.3638
  late_60_89 > 0.00                        +0.2271
  late_30_59 > 0.00                        +0.1520
  revolving_utilization > 0.56             +0.1360
  open_credit_lines > 11.00                +0.0290
random_state=1:
  late_90 > 0.00                           +0.3497
  late_60_89 > 0.00                        +0.2354
  late_30_59 > 0.00                        +0.1664
  revolving_utilization > 0.56             +0.1388
  open_credit_lines > 11.00                +0.0322
random_state=2:
  late_90 > 0.00                           +0.3546
  late_60_89 > 0.00                        +0.2240
  late_30_59 > 0.00                        +0.1559
  revolving_utilization > 0.56             +0.1357
  open_credit_lines > 11.00                +0.0269
- Výber príznakov sa zhoduje so SHAP: tri omeškania +
revolving_utilizationv top 4, všetky so zvyšujúcim smerom. Poradie je takmer rovnaké (SHAP: late_90, late_60_89, revolving, late_30_59; LIME: late_90, late_60_89, late_30_59, revolving). Piaty príznak sa líši (SHAPdebt_ratio, LIMEopen_credit_liness malou váhou). - LIME váhy sú v jednotkách pravdepodobnosti lokálneho lineárneho modelu nad binarizovanými príznakmi („late_90 > 0“), preto nie sú priamo porovnateľné so SHAP v log-odds.
- Pri troch
random_statesa výber a poradie nemenia, váhy sa hýbu rádovo o ±0,01 (napr. late_90: 0,364 / 0,350 / 0,355). LIME je stochastický (náhodné perturbácie okolia), pri tomto výraznom klientovi je však stabilný. Pri klientoch blízko rozhodovacej hranice býva rozptyl oveľa väčší; SHAP pre stromy (TreeExplainer) je naopak deterministický.
2 · PDP + ICE pre revolving_utilization
from sklearn.inspection import PartialDependenceDisplay
fig, ax = plt.subplots(figsize=(7, 4.5))
PartialDependenceDisplay.from_estimator(explained_model, X_explain.iloc[:200], ["revolving_utilization"],
                                        kind="both", percentiles=(0.01, 0.99), ax=ax, random_state=42)
plt.show()
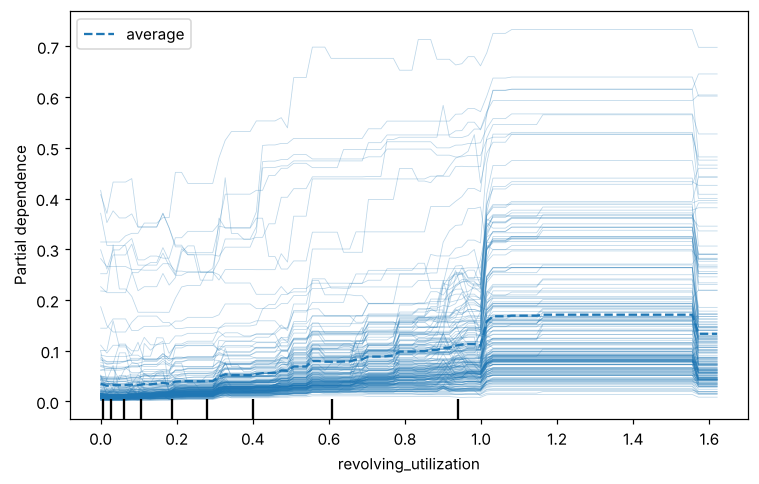
Priemerná krivka (PDP, prerušovaná) a 200 ICE kriviek jednotlivých klientov.
- Priemerná krivka rastie od ~0,03 po ~0,11 pri hodnote 1, potom skok na ~0,17 nad 1,0 (čerpanie nad limit) – rovnaký rastúci trend ako graf závislosti SHAP z 2.1. Rozdiel: PDP je v pravdepodobnosti (nie log-odds) a na osi 0–1 nevidno skok nad 1, lebo SHAP graf bol orezaný na 99. percentil.
- ICE krivky sa nelíšia iba posunom, ale aj tvarom. Klienti s vysokým základným rizikom (omeškania) majú pri prechode cez 1,0 skok o 0,2–0,3, nízkorizikoví takmer plochú čiaru. Niektoré krivky dokonca lokálne klesajú (výkyvy okolo 0,9 a pokles pri ~1,55). To potvrdzuje interakcie, ktoré sme videli ako vertikálny rozptyl v SHAP grafe závislosti – a v pravdepodobnostnej škále sa ešte zosilnia, lebo sigmoid je strmší v strede.
Zhrnutie – čo si zapamätať
- Model ≠ jeho interpretácia ≠ realita. Koeficienty aj SHAP opisujú model, nie príčiny.
- Stabilitu overuj bootstrapom. Pri malých dátach sa menia znamienka koeficientov aj poradie dôležitosti; pri 90 000 riadkoch sú výsledky stabilné.
- Korelované príznaky ničia interpretáciu koeficientov (late_60_89 = −3,86) – model si váhu prerozdeľuje.
- SHAP je aditívny a presný: základ + príspevky = výstup v log-odds; globálne = priemer |SHAP|.
- Kontrafaktuály dávajú konkrétnu odpoveď „čo zmeniť“, ale nie kauzálnu radu, a pre časť klientov neexistujú.
- Monotónne obmedzenia vynútia doménovo rozumné správanie zadarmo (tu dokonca s miernym zlepšením AUC).