Praktická úloha 1 - Titanic (prežitie cestujúcich)
Navigation
Cieľ úlohy
Dosiahnuť čo najvyššiu hodnotu metriky Average Precision (AP, plocha pod precision-recall krivkou v implementácii average_precision_score) pri predikcii prežitia cestujúcich (survived).
Modely optimalizujte a porovnávajte pomocou krížovej validácie. Testovaciu množinu použite výhradne na záverečné vyhodnotenie. Postupujte podľa nasledujúcich krokov.
Dátová sada
Titanic (OpenML) - cieľová premenná survived (1 = prežil, 0 = neprežil). Nasledujúca bunka dáta iba načíta, zvyšné spracovanie je súčasťou Kroku 1.
from sklearn.datasets import fetch_openml

titanic = fetch_openml(name="titanic", version=1, as_frame=True)
X = titanic.data
y = titanic.target.astype(int)

print(f"Shape: {X.shape}")
X.head()
Shape: (1309, 13)
| pclass | name | sex | age | sibsp | parch | ticket | fare | cabin | embarked | boat | body | home.dest | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | Allen, Miss. Elisabeth Walton | female | 29.0000 | 0 | 0 | 24160 | 211.3375 | B5 | S | 2 | NaN | St Louis, MO |
| 1 | 1 | Allison, Master. Hudson Trevor | male | 0.9167 | 1 | 2 | 113781 | 151.5500 | C22 C26 | S | 11 | NaN | Montreal, PQ / Chesterville, ON |
| 2 | 1 | Allison, Miss. Helen Loraine | female | 2.0000 | 1 | 2 | 113781 | 151.5500 | C22 C26 | S | NaN | NaN | Montreal, PQ / Chesterville, ON |
| 3 | 1 | Allison, Mr. Hudson Joshua Creighton | male | 30.0000 | 1 | 2 | 113781 | 151.5500 | C22 C26 | S | NaN | 135.0 | Montreal, PQ / Chesterville, ON |
| 4 | 1 | Allison, Mrs. Hudson J C (Bessie Waldo Daniels) | female | 25.0000 | 1 | 2 | 113781 | 151.5500 | C22 C26 | S | NaN | NaN | Montreal, PQ / Chesterville, ON |
Zaznamenávanie výsledkov
Do tabuľky results počas celého postupu zaznamenávajte výsledky jednotlivých konfigurácií (krok, model/konfigurácia, metrika, hodnota).
import pandas as pd

# tabuľka na zaznamenávanie výsledkov - po každom kroku pridajte riadok, napr.:
# results.loc[len(results)] = ["krok 2", "filter, 5 príznakov", "AP", 0.71]
results = pd.DataFrame(columns=["krok", "model", "metrika", "hodnota"])
results
| krok | model | metrika | hodnota |
|---|
Postup
Krok 1 - Príprava dát a návrh experimentu
- Preskúmajte rozmery dátovej sady, typy príznakov, počet chýbajúcich hodnôt v jednotlivých príznakoch a zastúpenie tried
survived. - Zabezpečte vhodné predspracovanie dát s ohľadom na ich charakter (chýbajúce hodnoty, kategorické príznaky) a použité klasifikačné modely.
- Pripravte trénovaciu a testovaciu množinu a vhodný postup krížovej validácie.
- Zabezpečte, aby pri predspracovaní, výbere príznakov a optimalizácii modelov nedochádzalo k úniku informácií.
# 1.Preskúmajte rozmery dátovej sady, typy príznakov, počet chýbajúcich hodnôt v jednotlivých príznakoch a zastúpenie tried `survived`.
# rozmery datovej sady
print(X.shape)
print("-" * 50)
# typy priznakov
print(X.info())
print("-" * 50)
# počet chýbajúcich hodnôt v jednotlivých príznakoch
print(X.isna().sum())
print("-" * 50)
# zastúpenie tried `survived`
print(y.value_counts(normalize=True))
print("-" * 50)

print((X.isna().mean() * 100).round(1).sort_values(ascending=False))

print("-" * 50)
print(X.nunique().sort_values(ascending=False))

print("-" * 50)
print(X["embarked"].value_counts(dropna=False))
print(X["sex"].value_counts(dropna=False))
print("-" * 50)
print("-" * 50)
print(pd.crosstab(X["boat"].notna(), y))
print(pd.crosstab(X["body"].notna(), y))
print("-" * 50)
print(pd.DataFrame({
    "dtype": X.dtypes,
    "missing_%": (X.isna().mean() * 100).round(1),
    "unique": X.nunique(),
}))
print("-" * 50)

print("-" * 50)
print(pd.crosstab(X["boat"].notna(), y, normalize="index").round(2))
print(pd.crosstab(X["body"].notna(), y, normalize="index").round(2))

print("-" * 50)
print(X[["parch", "fare"]].describe())
(1309, 13)
--------------------------------------------------
<class 'pandas.DataFrame'>
RangeIndex: 1309 entries, 0 to 1308
Data columns (total 13 columns):
 #   Column     Non-Null Count  Dtype
---  ------     --------------  -----
 0   pclass     1309 non-null   int64
 1   name       1309 non-null   str
 2   sex        1309 non-null   category
 3   age        1046 non-null   float64
 4   sibsp      1309 non-null   int64
 5   parch      1309 non-null   int64
 6   ticket     1309 non-null   str
 7   fare       1308 non-null   float64
 8   cabin      295 non-null    str
 9   embarked   1307 non-null   category
 10  boat       486 non-null    str
 11  body       121 non-null    float64
 12  home.dest  745 non-null    str
dtypes: category(2), float64(3), int64(3), str(5)
memory usage: 115.2 KB
None
--------------------------------------------------
pclass          0
name            0
sex             0
age           263
sibsp           0
parch           0
ticket          0
fare            1
cabin        1014
embarked        2
boat          823
body         1188
home.dest     564
dtype: int64
--------------------------------------------------
survived
0    0.618029
1    0.381971
Name: proportion, dtype: float64
--------------------------------------------------
body         90.8
cabin        77.5
boat         62.9
home.dest    43.1
age          20.1
embarked      0.2
fare          0.1
name          0.0
pclass        0.0
sibsp         0.0
sex           0.0
parch         0.0
ticket        0.0
dtype: float64
--------------------------------------------------
name         1307
ticket        929
home.dest     369
fare          281
cabin         186
body          121
age            98
boat           27
parch           8
sibsp           7
pclass          3
embarked        3
sex             2
dtype: int64
--------------------------------------------------
embarked
S      914
C      270
Q      123
NaN      2
Name: count, dtype: int64
sex
male      843
female    466
Name: count, dtype: int64
--------------------------------------------------
--------------------------------------------------
survived    0    1
boat
False     800   23
True        9  477
survived    0    1
body
False     688  500
True      121    0
--------------------------------------------------
              dtype  missing_%  unique
pclass        int64        0.0       3
name            str        0.0    1307
sex        category        0.0       2
age         float64       20.1      98
sibsp         int64        0.0       7
parch         int64        0.0       8
ticket          str        0.0     929
fare        float64        0.1     281
cabin           str       77.5     186
embarked   category        0.2       3
boat            str       62.9      27
body        float64       90.8     121
home.dest       str       43.1     369
--------------------------------------------------
--------------------------------------------------
survived     0     1
boat
False     0.97  0.03
True      0.02  0.98
survived     0     1
body
False     0.58  0.42
True      1.00  0.00
--------------------------------------------------
             parch         fare
count  1309.000000  1308.000000
mean      0.385027    33.295479
std       0.865560    51.758668
min       0.000000     0.000000
25%       0.000000     7.895800
50%       0.000000    14.454200
75%       0.000000    31.275000
max       9.000000   512.329200
# 2. Zabezpečte vhodné predspracovanie dát s ohľadom na ich charakter (chýbajúce hodnoty, kategorické príznaky) a použité klasifikačné modely.
# vyber stlpcov
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler

drop_cols=["body", "boat", "name", "ticket", "cabin", "home.dest"]
X_model=X.drop(columns=drop_cols)
num_cols=["pclass", "parch", "age", "sibsp","fare"]
cat_cols=["sex", "embarked"]

print(X_model.shape)
print("-" * 50)
print(X_model.isna().sum())
print("-" * 50)

# predspracovanie
preprocess = ColumnTransformer([
  # numerical: fill missing with median, then scale (needed by the regularized linear model)
    ("num", make_pipeline(SimpleImputer(strategy="median"), StandardScaler()), num_cols),
    # categorical: fill missing with the most frequent value, then one-hot encode
    ("cat", make_pipeline(SimpleImputer(strategy="most_frequent"), OneHotEncoder(handle_unknown="ignore")), cat_cols),
])
print("-" * 50)

print("-" * 50)

# public = [a for a in dir(y) if not a.startswith("_")]
# print(public)print(titanic.DESCR)
(1309, 7)
--------------------------------------------------
pclass        0
sex           0
age         263
sibsp         0
parch         0
fare          1
embarked      2
dtype: int64
--------------------------------------------------
--------------------------------------------------
--------------------------------------------------
Predspracovanie
- Odstránené príznaky:
boat,body– únik cieľovej premennej: cestujúci so záznamom vboatprežili v 98 % prípadov, so záznamom vbodyv 0 % (údaje vznikli až po nešťastí),name,ticket– takmer unikátne hodnoty,home.dest– voľný text,cabin– ~77 % chýbajúcich hodnôt.- Použité príznaky: číselné
pclass, age, sibsp, parch, fare, kategorickésex, embarked. - Chýbajúce hodnoty:
age(263) afare(1) dopĺňame mediánom,embarked(2) najčastejšou hodnotou. - Kategorické príznaky kódujeme one-hot (
OneHotEncoder). - Číselné príznaky štandardizujeme (
StandardScaler), pretože to vyžaduje lineárny model s regularizáciou (Prednáška 1, sekcia 2.8). Stromovým modelom škálovanie neprekáža (Prednáška 2, sekcia 1.1). - Predspracovanie bude prvým krokom v
Pipeline, takže sa v každom folde krížovej validácie učí iba z trénovacej časti.
# 3. Pripravte trénovaciu a testovaciu množinu a vhodný postup krížovej validácie.
from sklearn.model_selection import StratifiedKFold, train_test_split

RANDOM_STATE = 42
X_train, X_test, y_train, y_test = train_test_split(
  X_model, y, test_size=0.2, stratify=y, random_state=RANDOM_STATE
)

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=RANDOM_STATE)

print(f"Train: {X_train.shape}, test: {X_test.shape}")
print(f"Survival share - train: {y_train.mean():.3f}, test: {y_test.mean():.3f}")
Train: (1047, 7), test: (262, 7)
Survival share - train: 0.382, test: 0.382
Dáta delíme v pomere 80 : 20. Vďaka stratify=y je podiel prežitých (~38 %) rovnaký v trénovacej aj testovacej časti a random_state=42 zaručí rovnaké rozdelenie pri každom spustení. Testovaciu množinu použijeme iba na záverečné vyhodnotenie v Kroku 5. Modely porovnávame 5-násobnou stratifikovanou krížovou validáciou (StratifiedKFold, shuffle=True) na trénovacej množine. Rovnaké foldy používame vo všetkých krokoch, aby boli výsledky porovnateľné.
# 4. Zabezpečte, aby pri predspracovaní, výbere príznakov a optimalizácii modelov nedochádzalo k úniku informácií.
Krok 2 - Výber príznakov
Preskúmajte vplyv výberu príznakov na klasifikačnú výkonnosť.
- Vytvorte referenčný klasifikačný model využívajúci všetky dostupné príznaky po predspracovaní.
- Použite aspoň dve rôzne metódy výberu príznakov z prístupov filter, wrapper a embedded.
- Pre každú metódu preskúmajte nasledujúce počty vybraných príznakov:
- 3 príznaky
- 5 príznakov
- 8 príznakov
- všetky príznaky
- Pomocou krížovej validácie porovnajte jednotlivé konfigurácie podľa metriky AP.
- Zobrazte graf závislosti validačného skóre od počtu vybraných príznakov pre použité metódy.
Výber príznakov musí byť súčasťou validačného postupu. Vybrané príznaky sa nesmú určovať na celej dátovej sade pred krížovou validáciou.
# 2.1
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score
from sklearn.pipeline import Pipeline

baseline = Pipeline([
  ("prep", preprocess),
  ("clf", LogisticRegression(max_iter=1000))
])

baseline_scores = cross_val_score(baseline, X_train, y_train, scoring="average_precision")

print(f"AP per fold: {baseline_scores.round(3)}")
print(f"Baseline AP: {baseline_scores.mean():.4f} ± {baseline_scores.std(ddof=1):.4f}")

results.loc[len(results)] = ["krok 2", "LogReg, všetky príznaky", "AP", baseline_scores.mean()]

# number of features after preprocessing (one-hot creates more columns)
n_all = len(preprocess.fit(X_train).get_feature_names_out())
print("Number of features after preprocessing:", n_all)
AP per fold: [0.818 0.797 0.786 0.845 0.772]
Baseline AP: 0.8036 ± 0.0289
Number of features after preprocessing: 10
# 2.2 Použite aspoň dve rôzne metódy výberu príznakov z prístupov filter, wrapper a embedded.
import numpy as np
from sklearn.feature_selection import RFE, SelectFromModel, SelectKBest, f_classif

def make_selector(method, k):
  """Return a feature selector that keeps k features."""
  if method == "filter (ANOVA F)":
    # scores every feature by a statistical test, keeps the k best
    return SelectKBest(f_classif, k=k)
  if method == "wrapper (RFE)":
        # repeatedly fits the model and removes the weakest feature
        return RFE(LogisticRegression(max_iter=1000), n_features_to_select=k)
  if method == "embedded (L1)":
      # L1-regularized model, keeps the k features with the largest |coefficient|
      return SelectFromModel(LogisticRegression(l1_ratio=1.0, solver="liblinear"),
                               max_features=k, threshold=-np.inf)

methods = ["filter (ANOVA F)", "wrapper (RFE)", "embedded (L1)"]

# quick check: every method with 5 features
for method in methods:
  pipe = Pipeline([
    ("prep", preprocess),
    ("select", make_selector(method, 5)),
    ("clf", LogisticRegression(max_iter=1000)),
  ])

  pipe.fit(X_train, y_train)
  print(f"{method:18s} → {list(pipe[:-1].get_feature_names_out())}")

pipe_f = Pipeline([("prep", preprocess), ("select", make_selector("filter (ANOVA F)", 5))]).fit(X_train, y_train)
print("FILTER - F score:")
print(pd.Series(pipe_f["select"].scores_, index=pipe_f["prep"].get_feature_names_out()).sort_values(ascending=False))

pipe_r = Pipeline([("prep", preprocess), ("select", make_selector("wrapper (RFE)", 5))]).fit(X_train, y_train)
print("\nWRAPPER - RFE ranking (1 = kept):")
print(pd.Series(pipe_r["select"].ranking_, index=pipe_r["prep"].get_feature_names_out()).sort_values())

pipe_l = Pipeline([("prep", preprocess), ("select", make_selector("embedded (L1)", 5))]).fit(X_train, y_train)
print("\nEMBEDDED - |L1 coefficient|:")
print(pd.Series(pipe_l["select"].estimator_.coef_[0], index=pipe_l["prep"].get_feature_names_out()).abs().sort_values(ascending=False))
filter (ANOVA F)   → ['num__pclass', 'num__fare', 'cat__sex_female', 'cat__sex_male', 'cat__embarked_C']
wrapper (RFE)      → ['num__pclass', 'num__age', 'cat__sex_female', 'cat__sex_male', 'cat__embarked_C']
embedded (L1)      → ['num__pclass', 'num__age', 'cat__sex_female', 'cat__sex_male', 'cat__embarked_C']
FILTER - F score:
cat__sex_male      381.225175
cat__sex_female    381.225175
num__pclass        103.020647
num__fare           68.159077
cat__embarked_C     46.270475
cat__embarked_S     26.698427
num__parch          11.448584
num__age             3.893880
cat__embarked_Q      1.304881
num__sibsp           0.299589
dtype: float64

WRAPPER - RFE ranking (1 = kept):
num__pclass        1
num__age           1
cat__sex_male      1
cat__sex_female    1
cat__embarked_C    1
num__sibsp         2
cat__embarked_Q    3
cat__embarked_S    4
num__fare          5
num__parch         6
dtype: int64

EMBEDDED - |L1 coefficient|:
cat__sex_male      1.640752
cat__sex_female    0.840767
num__pclass        0.750265
cat__embarked_C    0.669806
num__age           0.459141
num__sibsp         0.300694
cat__embarked_Q    0.110882
num__fare          0.055873
num__parch         0.001953
cat__embarked_S    0.000000
dtype: float64
# 3. Pre každú metódu preskúmajte nasledujúce počty vybraných príznakov:
  #  - 3 príznaky
  #  - 5 príznakov
  #  - 8 príznakov
  #  - všetky príznaky

k_values = [3, 5, 8, n_all]          # n_all = 10 (all features after preprocessing)

rows = []
for method in methods:
  for k in k_values:
      pipe = Pipeline([
          ("prep", preprocess),
          ("select", make_selector(method, k)),
          ("clf", LogisticRegression(max_iter=1000)),
      ])
      scores = cross_val_score(pipe, X_train, y_train, cv=cv, scoring="average_precision")

      rows.append({"method": method, "k": k, "AP": scores.mean(), "AP_SD": scores.std(ddof=1)})
      results.loc[len(results)] = ["krok 2", f"{method}, {k} príznakov", "AP", scores.mean()]

fs_results = pd.DataFrame(rows)
print(fs_results.round(4).to_string(index=False))

# the same numbers as a table: rows = number of features, columns = method
fs_table = fs_results.pivot(index="k", columns="method", values="AP")
print()
print(fs_table.round(4))
print(f"\nBaseline (all features, no selection): {baseline_scores.mean():.4f}")
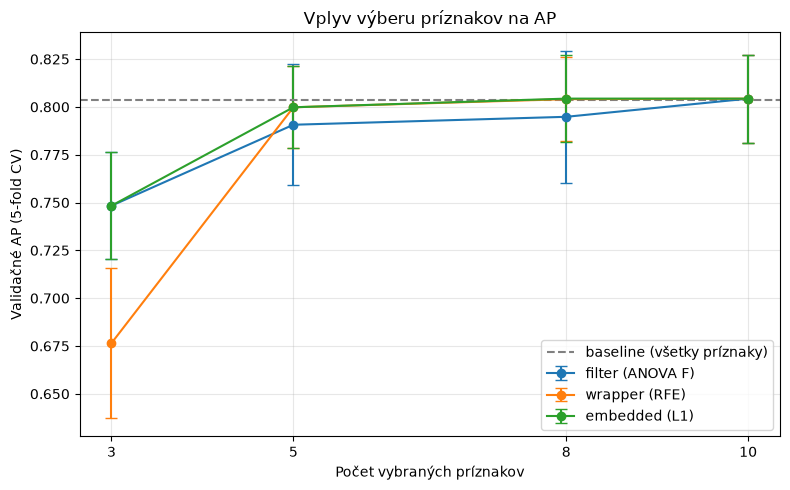
          method  k     AP  AP_SD
filter (ANOVA F)  3 0.7483 0.0280
filter (ANOVA F)  5 0.7907 0.0316
filter (ANOVA F)  8 0.7948 0.0346
filter (ANOVA F) 10 0.8043 0.0231
   wrapper (RFE)  3 0.6765 0.0392
   wrapper (RFE)  5 0.7998 0.0214
   wrapper (RFE)  8 0.8041 0.0219
   wrapper (RFE) 10 0.8043 0.0231
   embedded (L1)  3 0.7483 0.0280
   embedded (L1)  5 0.7998 0.0214
   embedded (L1)  8 0.8043 0.0229
   embedded (L1) 10 0.8043 0.0231

method  embedded (L1)  filter (ANOVA F)  wrapper (RFE)
k
3              0.7483            0.7483         0.6765
5              0.7998            0.7907         0.7998
8              0.8043            0.7948         0.8041
10             0.8043            0.8043         0.8043

Baseline (all features, no selection): 0.8036
# 4. Pomocou krížovej validácie porovnajte jednotlivé konfigurácie podľa metriky AP.
#           method  k     AP  AP_SD
# filter (ANOVA F)  3 0.7483 0.0280
# filter (ANOVA F)  5 0.7907 0.0316
# filter (ANOVA F)  8 0.7948 0.0346
# filter (ANOVA F) 10 0.8043 0.0231
#    wrapper (RFE)  3 0.6765 0.0392
#    wrapper (RFE)  5 0.7998 0.0214
#    wrapper (RFE)  8 0.8041 0.0219
#    wrapper (RFE) 10 0.8043 0.0231
#    embedded (L1)  3 0.7483 0.0280
#    embedded (L1)  5 0.7998 0.0214
#    embedded (L1)  8 0.8043 0.0229
#    embedded (L1) 10 0.8043 0.0231

# method  embedded (L1)  filter (ANOVA F)  wrapper (RFE)
# k
# 3              0.7483            0.7483         0.6765
# 5              0.7998            0.7907         0.7998
# 8              0.8043            0.7948         0.8041
# 10             0.8043            0.8043         0.8043

# Baseline (all features, no selection): 0.8036
# 5. Zobrazte graf závislosti validačného skóre od počtu vybraných príznakov pre použité metódy.

import matplotlib.pyplot as plt

fig, ax = plt.subplots(figsize=(8, 5))

for method in methods:
    part = fs_results[fs_results["method"] == method]
    # line = mean AP, error bars = standard deviation over the 5 folds
    ax.errorbar(part["k"], part["AP"], yerr=part["AP_SD"], marker="o", capsize=4, label=method)

ax.axhline(baseline_scores.mean(), color="grey", linestyle="--", label="baseline (všetky príznaky)")
ax.set_xticks(k_values)
ax.set_xlabel("Počet vybraných príznakov")
ax.set_ylabel("Validačné AP (5-fold CV)")
ax.set_title("Vplyv výberu príznakov na AP")
ax.legend()
ax.grid(alpha=0.3)
plt.tight_layout()
plt.show()
Krok 3 - Optimalizácia klasifikačných modelov
Vytvorte a optimalizujte viacero klasifikačných modelov s cieľom maximalizovať validačnú hodnotu AP.
- Použite aspoň tri klasifikátory založené na odlišných princípoch učenia, pričom aspoň jeden musí byť lineárny model s regularizáciou (Cvičenie 3) a aspoň jeden stromový skupinový model (Cvičenie 4).
- Optimalizujte relevantné hyperparametre jednotlivých klasifikátorov pomocou krížovej validácie.
- Pri optimalizácii môžete využiť výsledky výberu príznakov z predchádzajúceho kroku a ďalej kombinovať jednotlivé metódy výberu príznakov s klasifikátormi.
- Porovnajte dosiahnuté validačné hodnoty AP jednotlivých modelov a ich konfigurácií.
- Zaznamenajte najlepšiu konfiguráciu každého klasifikátora vrátane použitých príznakov a hyperparametrov.
# 3. Vytvorte a optimalizujte viacero klasifikačných modelov s cieľom maximalizovať validačnú hodnotu AP.
# 1. Použite aspoň tri klasifikátory založené na odlišných princípoch učenia, pričom aspoň jeden musí byť lineárny model s regularizáciou (Cvičenie 3) a aspoň jeden stromový skupinový model (Cvičenie 4).
from sklearn.ensemble import RandomForestClassifier
from sklearn.neighbors import KNeighborsClassifier

models = {
    # linear model with L2 regularization (default), strength set by C
    "Logistic regression": LogisticRegression(max_iter=1000),
    # tree ensemble - many decision trees, prediction = average
    "Random forest": RandomForestClassifier(random_state=RANDOM_STATE, n_jobs=-1),
    # k nearest neighbours - looks at the most similar passengers in the training data
    "KNN": KNeighborsClassifier(),
}

rows = []
for name, clf in models.items():
    pipe = Pipeline([("prep", preprocess), ("clf", clf)])
    scores = cross_val_score(pipe, X_train, y_train, cv=cv, scoring="average_precision")
    rows.append({"model": name, "AP": scores.mean(), "AP_SD": scores.std(ddof=1)})
    results.loc[len(results)] = ["krok 3", f"{name}, predvolené nastavenia", "AP", scores.mean()]

default_results = pd.DataFrame(rows).set_index("model")
print(default_results.round(4))
                         AP   AP_SD
model
Logistic regression  0.8043  0.0231
Random forest        0.8006  0.0266
KNN                  0.7370  0.0387
# 2. Optimalizujte relevantné hyperparametre jednotlivých klasifikátorov pomocou krížovej validácie.
from sklearn.model_selection import GridSearchCV

searches = {
    "Logistic regression": (
        LogisticRegression(solver="saga", max_iter=5000),
        {
            "clf__C": [0.01, 0.1, 1, 10, 100],      # sila regularizácie (menšie C = silnejšia)
            "clf__l1_ratio": [0.0, 0.5, 1.0],       # 0 = L2 (Ridge), 1 = L1 (Lasso), 0.5 = Elastic Net
        },
    ),
    "Random forest": (
        RandomForestClassifier(n_estimators=300, random_state=RANDOM_STATE, n_jobs=-1),
        {
            "clf__max_depth": [None, 4, 6, 8],      # max. hĺbka stromu (None = bez obmedzenia)
            "clf__min_samples_leaf": [1, 3, 5, 10], # min. počet ľudí v liste
            "clf__max_features": ["sqrt", 0.5],     # koľko príznakov zvažuje pri delení
        },
    ),
    "KNN": (
        KNeighborsClassifier(),
        {
            "clf__n_neighbors": [5, 11, 21, 31, 51],   # počet susedov
            "clf__weights": ["uniform", "distance"],   # rovnaký hlas / bližší sused má väčší hlas
        },
    ),
}

best_models = {}
rows = []
for name, (clf, grid) in searches.items():
  pipe = Pipeline([("prep", preprocess), ("clf", clf)])
  search = GridSearchCV(pipe, grid, cv=cv, scoring="average_precision", n_jobs=-1)
  search.fit(X_train, y_train)
  best_models[name] = search.best_estimator_
  best_sd = search.cv_results_["std_test_score"][search.best_index_]
  rows.append({"model": name, "AP": search.best_score_, "AP_SD": best_sd, "best_params": search.best_params_})
  results.loc[len(results)] = ["krok 3", f"{name}, ladený {search.best_params_}", "AP", search.best_score_]

tuned_results = pd.DataFrame(rows).set_index("model")
print(tuned_results.round(4).to_string())
                         AP   AP_SD                                                                     best_params
model
Logistic regression  0.8061  0.0195                                           {'clf__C': 0.1, 'clf__l1_ratio': 0.5}
Random forest        0.8268  0.0082  {'clf__max_depth': 6, 'clf__max_features': 'sqrt', 'clf__min_samples_leaf': 1}
KNN                  0.7852  0.0118                             {'clf__n_neighbors': 21, 'clf__weights': 'uniform'}
# 3. Pri optimalizácii môžete využiť výsledky výberu príznakov z predchádzajúceho kroku a ďalej kombinovať jednotlivé metódy výberu príznakov s klasifikátormi.
from sklearn.base import clone
# feature-selection options tried with every tuned model ("passthrough" = no selection, all 10 features)
selector_labels = ["všetky príznaky"]
selector_options = ["passthrough"]

for method in methods:
    for k in [3, 5, 8]:
        selector_labels.append(f"{method}, {k}")
        selector_options.append(make_selector(method, k))

final_rows = []
for name, best in best_models.items():
    pipe = Pipeline([
        ("prep", preprocess),
        ("select", "passthrough"),
        ("clf", clone(best["clf"])),        # tuned model from point 2 (unfitted copy)
    ])
    search = GridSearchCV(pipe, {"select": selector_options}, cv=cv, scoring="average_precision", n_jobs=-1)
    search.fit(X_train, y_train)

    best_models[name] = search.best_estimator_
    final_rows.append({
        "model": name,
        "AP": search.best_score_,
        "AP_SD": search.cv_results_["std_test_score"][search.best_index_],
        "výber príznakov": selector_labels[search.best_index_],
        "počet príznakov": len(search.best_estimator_[:-1].get_feature_names_out()),
        "príznaky": list(search.best_estimator_[:-1].get_feature_names_out()),
        "hyperparametre": {k.replace("clf__", ""): v for k, v in tuned_results.loc[name, "best_params"].items()},
    })
    results.loc[len(results)] = ["krok 3", f"{name}, ladený + {selector_labels[search.best_index_]}", "AP", search.best_score_]

final_results = pd.DataFrame(final_rows).set_index("model")
print(final_results[["AP", "AP_SD", "výber príznakov", "počet príznakov"]].round(4).to_string())
                         AP   AP_SD   výber príznakov  počet príznakov
model
Logistic regression  0.8061  0.0195   všetky príznaky               10
Random forest        0.8268  0.0082   všetky príznaky               10
KNN                  0.7906  0.0268  embedded (L1), 8                8
# 4. Porovnajte dosiahnuté validačné hodnoty AP jednotlivých modelov a ich konfigurácií.
comparison = pd.DataFrame({
  "default": default_results["AP"],
  "tuned": tuned_results['AP'],
  "tuned + feature selection": final_results["AP"]
})
print(comparison.round(4))
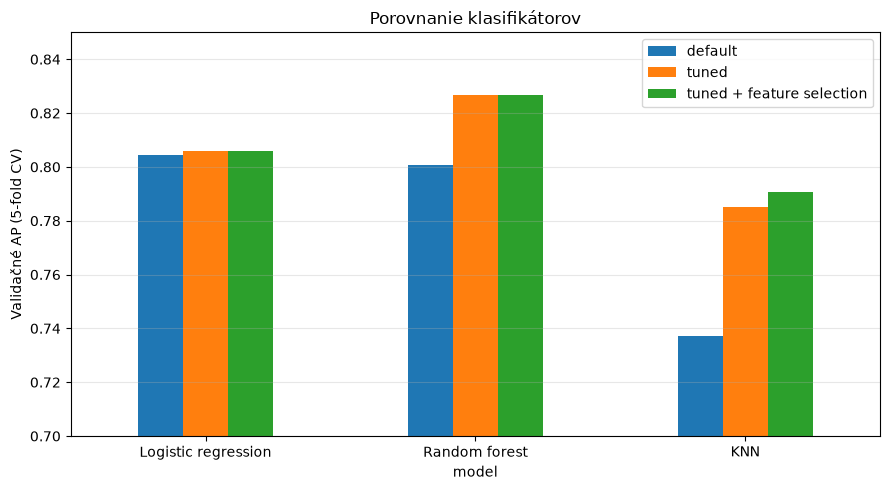
ax = comparison.plot(kind="bar", figsize=(9, 5), rot=0, ylim=(0.70, 0.85))
ax.set_ylabel("Validačné AP (5-fold CV)")
ax.set_title("Porovnanie klasifikátorov")
ax.grid(axis="y", alpha=0.3)
plt.tight_layout()
plt.show()
                     default   tuned  tuned + feature selection
model
Logistic regression   0.8043  0.8061                     0.8061
Random forest         0.8006  0.8268                     0.8268
KNN                   0.7370  0.7852                     0.7906
# 5. Zaznamenajte najlepšiu konfiguráciu každého klasifikátora vrátane použitých príznakov a hyperparametrov.
for name, row in final_results.iterrows():
    print(f"{name}")
    print(f"  AP:              {row['AP']:.4f} ± {row['AP_SD']:.4f}")
    print(f"  výber príznakov: {row['výber príznakov']} ({row['počet príznakov']})")
    print(f"  príznaky:        {row['príznaky']}")
    print(f"  hyperparametre:  {row['hyperparametre']}")
Logistic regression
  AP:              0.8061 ± 0.0195
  výber príznakov: všetky príznaky (10)
  príznaky:        ['num__pclass', 'num__parch', 'num__age', 'num__sibsp', 'num__fare', 'cat__sex_female', 'cat__sex_male', 'cat__embarked_C', 'cat__embarked_Q', 'cat__embarked_S']
  hyperparametre:  {'C': 0.1, 'l1_ratio': 0.5}
Random forest
  AP:              0.8268 ± 0.0082
  výber príznakov: všetky príznaky (10)
  príznaky:        ['num__pclass', 'num__parch', 'num__age', 'num__sibsp', 'num__fare', 'cat__sex_female', 'cat__sex_male', 'cat__embarked_C', 'cat__embarked_Q', 'cat__embarked_S']
  hyperparametre:  {'max_depth': 6, 'max_features': 'sqrt', 'min_samples_leaf': 1}
KNN
  AP:              0.7906 ± 0.0268
  výber príznakov: embedded (L1), 8 (8)
  príznaky:        ['num__pclass', 'num__age', 'num__sibsp', 'num__fare', 'cat__sex_female', 'cat__sex_male', 'cat__embarked_C', 'cat__embarked_Q']
  hyperparametre:  {'n_neighbors': 21, 'weights': 'uniform'}
Krok 4 - Heterogénny skupinový model
Pokúste sa zlepšiť klasifikačnú výkonnosť kombinovaním viacerých odlišných klasifikátorov.
- Zostavte heterogénny skupinový model využívajúci aspoň tri základné klasifikátory z Kroku 3.
- Použite hlasovanie na základe predikovaných pravdepodobností alebo skladanie modelov (stacking).
- Experimentujte s výberom základných klasifikátorov a prípadne s ich váhami alebo konfiguráciou meta-modelu.
- Vyhodnoťte skupinový model pomocou rovnakej validačnej stratégie a metriky AP.
- Porovnajte jeho výsledok s najlepším samostatným klasifikátorom.
# 4. Pokúste sa zlepšiť klasifikačnú výkonnosť kombinovaním viacerých odlišných klasifikátorov.

# 4.1. Zostavte heterogénny skupinový model využívajúci aspoň tri základné klasifikátory z Kroku 3.
from sklearn.model_selection import cross_validate

fold_scores = {
  name: cross_val_score(model, X_train, y_train, cv=cv, scoring="average_precision")
  for name, model in best_models.items()
}

for name, scores in fold_scores.items():
  print(f"{name:20s} {scores.round(4)}  mean {scores.mean():.4f}")

best_single = max(fold_scores, key=lambda name: fold_scores[name].mean())
print("\nBest single model:", best_single)
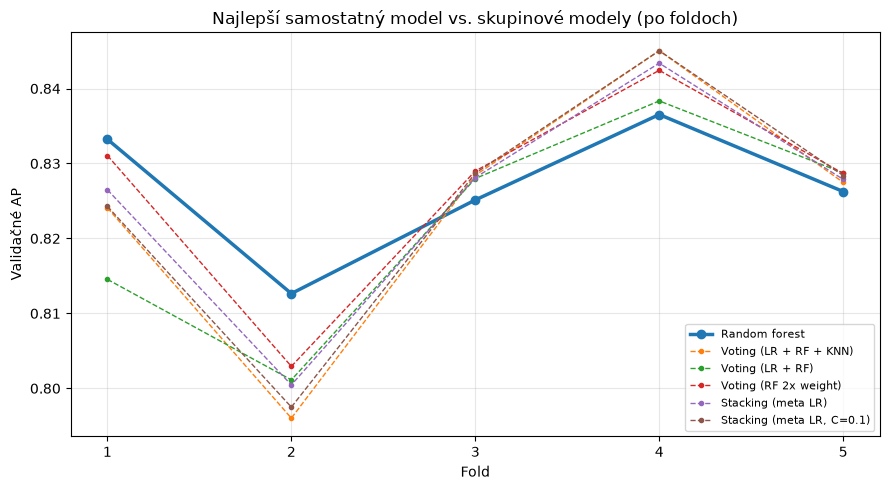
Logistic regression  [0.7946 0.7734 0.8169 0.8262 0.8193]  mean 0.8061
Random forest        [0.8332 0.8126 0.8251 0.8365 0.8263]  mean 0.8268
KNN                  [0.8013 0.7472 0.8023 0.826  0.7761]  mean 0.7906

Best single model: Random forest
# 4.2. Použite hlasovanie na základe predikovaných pravdepodobností alebo skladanie modelov (stacking).
from sklearn.ensemble import StackingClassifier, VotingClassifier
base = list(best_models.items())
ensembles = {
    "Voting (LR + RF + KNN)": VotingClassifier(base, voting="soft"),
    "Voting (LR + RF)": VotingClassifier(base[:2], voting="soft"),
    "Voting (RF 2x weight)": VotingClassifier(base, voting="soft", weights=[1, 2, 1]),
    "Stacking (meta LR)": StackingClassifier(base, final_estimator=LogisticRegression(),
                                             stack_method="predict_proba", cv=5),
    "Stacking (meta LR, C=0.1)": StackingClassifier(base, final_estimator=LogisticRegression(C=0.1),
                                                    stack_method="predict_proba", cv=5),
}
rows = []
for name, model in ensembles.items():
  res = cross_validate(model, X_train, y_train, cv=cv, scoring="average_precision", return_estimator=isinstance(model, StackingClassifier))
  scores = res["test_score"]
  fold_scores[name] = scores
  diff = scores - fold_scores[best_single]
  rows.append({
      "model": name,
      "AP": scores.mean(),
      "AP_SD": scores.std(ddof=1),
      "diff_vs_best": diff.mean(),
      "folds_better": int((diff > 0).sum()),
  })
  results.loc[len(results)] = ["krok 4", name, "AP", scores.mean()]

  if isinstance(model, StackingClassifier):
      weights = np.mean([est.final_estimator_.coef_[0] for est in res["estimator"]], axis=0)
      print(f"{name} - meta-model weights:", dict(zip(best_models, weights.round(3))))

ensemble_results = pd.DataFrame(rows).set_index("model")
print(f"\nBest single model: {best_single} (AP {fold_scores[best_single].mean():.4f})")
print(ensemble_results.round(4).to_string())
Stacking (meta LR) - meta-model weights: {'Logistic regression': np.float64(1.602), 'Random forest': np.float64(2.65), 'KNN': np.float64(1.254)}
Stacking (meta LR, C=0.1) - meta-model weights: {'Logistic regression': np.float64(1.222), 'Random forest': np.float64(1.574), 'KNN': np.float64(1.318)}

Best single model: Random forest (AP 0.8268)
                               AP   AP_SD  diff_vs_best  folds_better
model
Voting (LR + RF + KNN)     0.8242  0.0177       -0.0025             3
Voting (LR + RF)           0.8221  0.0145       -0.0046             3
Voting (RF 2x weight)      0.8268  0.0145        0.0001             3
Stacking (meta LR)         0.8253  0.0155       -0.0015             3
Stacking (meta LR, C=0.1)  0.8248  0.0172       -0.0020             3
# 4.3. Experimentujte s výberom základných klasifikátorov a prípadne s ich váhami alebo konfiguráciou meta-modelu.
# - experimenty s modelmi, váhami a meta-modelom    3 modely vs. len LR + RF (base[:2]), váhy [1, 2, 1], meta-model s C=1 vs. C=0.1
# 4.4. Vyhodnoťte skupinový model pomocou rovnakej validačnej stratégie a metriky AP.
# - rovnaká CV a AP cross_validate(..., cv=cv, scoring="average_precision")

# Heterogénne skupinové modely (soft voting aj stacking z LR, RF a KNN, s rôznym výberom modelov, váhami a nastavením meta-modelu) dosiahli AP 0,822 až 0,827, teda na úrovni najlepšieho samostatného modelu Random forest (0,8268). Rozdiely (−0,005 až +0,0001) sú menšie ako smerodajná odchýlka medzi foldmi a nie sú konzistentné, keďže ensemble bol lepší iba v 3 z 5 foldov. Meta-model stackingu pridelil najväčšiu váhu Random forestu. Kombinácia nepomohla, pretože základné modely sú silne korelované a logistická regresia aj KNN sú slabšie ako Random forest.
# 4.5. Porovnajte jeho výsledok s najlepším samostatným klasifikátorom.
compare = [best_single] + list(ensembles)
fig, ax = plt.subplots(figsize=(9, 5))
for name in compare:
    style = "-o" if name == best_single else "--."
    ax.plot(range(1, 6), fold_scores[name], style, label=name, linewidth=2.5 if name == best_single else 1)
ax.set_xticks(range(1, 6))
ax.set_xlabel("Fold")
ax.set_ylabel("Validačné AP")
ax.set_title("Najlepší samostatný model vs. skupinové modely (po foldoch)")
ax.legend(fontsize=8); ax.grid(alpha=0.3)
plt.tight_layout(); plt.show()
Krok 5 - Výber a záverečné vyhodnotenie modelu
- Na základe validačných výsledkov vyberte konfiguráciu s najvyššou dosiahnutou hodnotou AP.
- Vybraný postup vrátane predspracovania a výberu príznakov natrénujte na celej trénovacej množine.
- Vyhodnoťte výsledný model na odloženej testovacej množine.
- Vypočítajte metriky AP, ROC-AUC, precision, recall a F1.
- Zobrazte precision-recall krivku a maticu zámen.
- Vytvorte záverečnú tabuľku obsahujúcu najlepšie validačné skóre, testovacie skóre a výslednú konfiguráciu modelu.
# 5.1. Na základe validačných výsledkov vyberte konfiguráciu s najvyššou dosiahnutou hodnotou AP.
cv_summary = pd.DataFrame({
  "CV_AP": {name: s.mean() for name, s in fold_scores.items()},
  "CV_SD": {name: s.std(ddof=1) for name, s in fold_scores.items()},
}).sort_values("CV_AP", ascending=False)
print(cv_summary.round(4))

all_candidates = {**best_models, **ensembles}
final_name = cv_summary["CV_AP"].idxmax()
print("\nSelected procedure:", final_name)
                            CV_AP   CV_SD
Voting (RF 2x weight)      0.8268  0.0145
Random forest              0.8268  0.0092
Stacking (meta LR)         0.8253  0.0155
Stacking (meta LR, C=0.1)  0.8248  0.0172
Voting (LR + RF + KNN)     0.8242  0.0177
Voting (LR + RF)           0.8221  0.0145
Logistic regression        0.8061  0.0218
KNN                        0.7906  0.0300

Selected procedure: Voting (RF 2x weight)
# 5.2. Vybraný postup vrátane predspracovania a výberu príznakov natrénujte na celej trénovacej množine.
# 5.3. Vyhodnoťte výsledný model na odloženej testovacej množine.
# 5.4. Vypočítajte metriky AP, ROC-AUC, precision, recall a F1.
from sklearn.base import clone
from sklearn.metrics import (average_precision_score, f1_score, precision_score,
                             recall_score, roc_auc_score)

# fit the whole procedure (preprocessing + feature selection + models) on the whole training set
final_model = clone(all_candidates[final_name]).fit(X_train, y_train)

# the ONLY use of the test set
test_proba = final_model.predict_proba(X_test)[:, 1]   # probability of survival
test_pred = final_model.predict(X_test)                 # class 0/1 (threshold 0.5)

test_metrics = {
    "AP": average_precision_score(y_test, test_proba),
    "ROC-AUC": roc_auc_score(y_test, test_proba),
    "precision": precision_score(y_test, test_pred),
    "recall": recall_score(y_test, test_pred),
    "F1": f1_score(y_test, test_pred),
}

# Metrika   Z čoho  Na čo odpovedá
# AP    pravdepodobnosti    Sú prežití v poradí hore?
# ROC-AUC   pravdepodobnosti    S akou pravdepodobnosťou dá model náhodnému prežitému vyššie číslo ako náhodnému neprežitému?
# precision 0/1 (prah 0,5)  Z tých, o ktorých model tvrdí „prežil“, koľko naozaj prežilo?
# recall    0/1 Z tých, čo naozaj prežili, koľkých našiel?
# F1    0/1 Precision a recall spojené do jedného čísla

for metric, value in test_metrics.items():
    print(f"{metric:10s} {value:.4f}")

results.loc[len(results)] = ["krok 5", f"{final_name} (test)", "AP", test_metrics["AP"]]
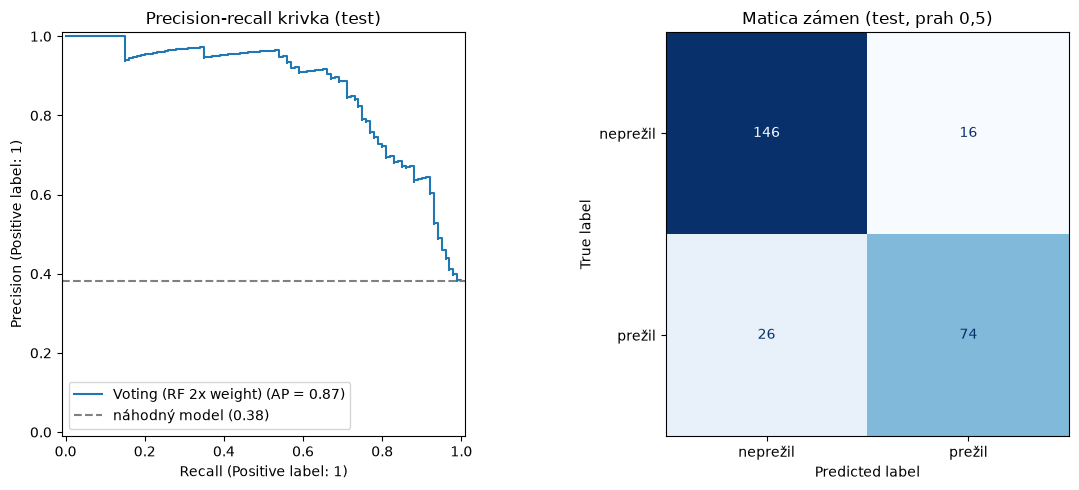
AP         0.8686
ROC-AUC    0.8900
precision  0.8222
recall     0.7400
F1         0.7789
# 5.5. Zobrazte precision-recall krivku a maticu zámen.
from sklearn.metrics import ConfusionMatrixDisplay, PrecisionRecallDisplay

fig, axes = plt.subplots(1, 2, figsize=(12, 5))

PrecisionRecallDisplay.from_predictions(y_test, test_proba, name=final_name, ax=axes[0])
axes[0].axhline(y_test.mean(), color="grey", linestyle="--", label=f"náhodný model ({y_test.mean():.2f})")
axes[0].set_title("Precision-recall krivka (test)")
axes[0].legend()

ConfusionMatrixDisplay.from_predictions(y_test, test_pred, display_labels=["neprežil", "prežil"],
                                        cmap="Blues", colorbar=False, ax=axes[1])
axes[1].set_title("Matica zámen (test, prah 0,5)")

plt.tight_layout()
plt.show()
# 5.6. Vytvorte záverečnú tabuľku obsahujúcu najlepšie validačné skóre, testovacie skóre a výslednú konfiguráciu modelu.
if final_name in best_models:
    configuration = f"{final_results.loc[final_name, 'výber príznakov']}, {final_results.loc[final_name, 'hyperparametre']}"
else:
    configuration = final_name + " = " + "; ".join(
        f"{name} ({final_results.loc[name, 'výber príznakov']}, {final_results.loc[name, 'hyperparametre']})"
        for name in best_models
    )

final_table = pd.DataFrame([{
    "postup": final_name,
    "CV AP": cv_summary.loc[final_name, "CV_AP"],
    "CV SD": cv_summary.loc[final_name, "CV_SD"],
    **{f"test {metric}": value for metric, value in test_metrics.items()},
}]).set_index("postup")

print(final_table.round(4).T)
print("\nKonfigurácia:", configuration)
postup          Voting (RF 2x weight)
CV AP                          0.8268
CV SD                          0.0145
test AP                        0.8686
test ROC-AUC                   0.8900
test precision                 0.8222
test recall                    0.7400
test F1                        0.7789

Konfigurácia: Voting (RF 2x weight) = Logistic regression (všetky príznaky, {'C': 0.1, 'l1_ratio': 0.5}); Random forest (všetky príznaky, {'max_depth': 6, 'max_features': 'sqrt', 'min_samples_leaf': 1}); KNN (embedded (L1), 8, {'n_neighbors': 21, 'weights': 'uniform'})